एआई समाचार
Unlimited OCR 2: स्कैन पीडीएफ से टेक्स्ट और टेबल निकालना
लंबे दस्तावेज़ों और स्कैन किए गए PDF से टेक्स्ट व टेबल निकालने के लिए Baidu के Unlimited OCR 2 को समझें। AI से सारांश लेने से पहले डेटा जाँचें।
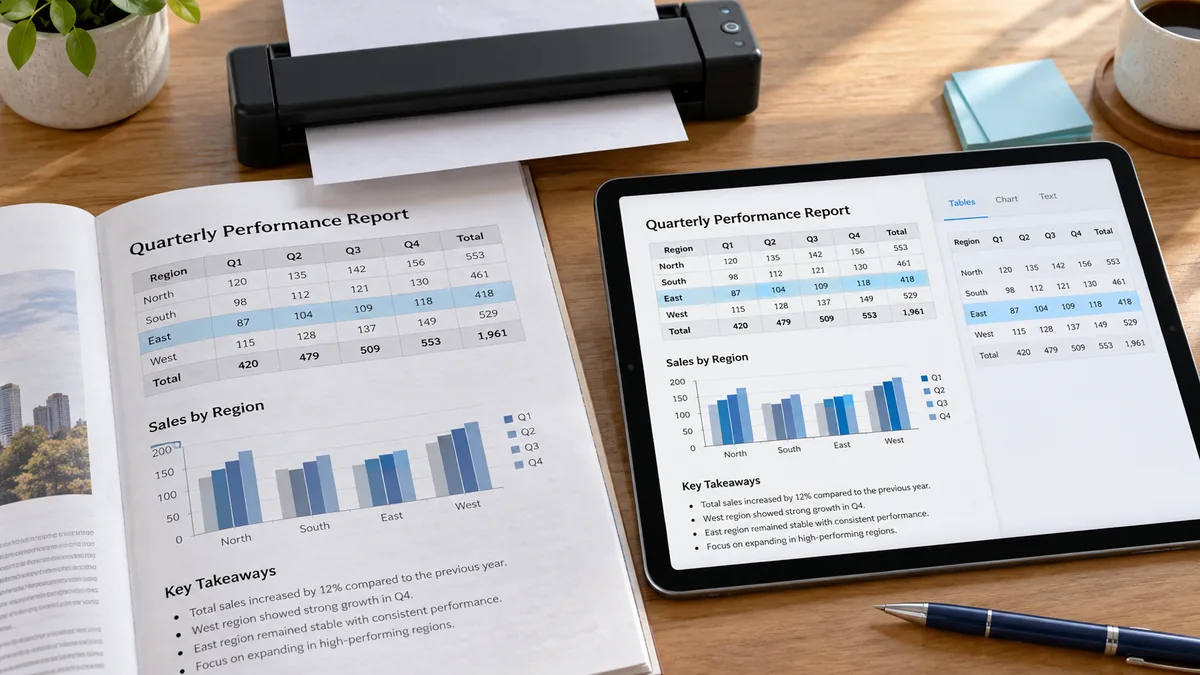
स्कैन किया गया PDF आपको पूरी तरह पढ़ने योग्य लग सकता है, फिर भी उसमें खोजना, कॉपी करना या सारांश बनाना मुश्किल हो सकता है। OCR पृष्ठ की छवि को टेक्स्ट में बदलता है; दस्तावेज़ पार्सिंग शीर्षकों और तालिकाओं जैसी संरचना जोड़ती है।
Unlimited OCR 2 उस वर्कफ़्लो में एक नई रिलीज़ है। यह गाइड घोषणा की व्याख्या करती है और अगले चरण के लिए एक छोटा, जाँचने योग्य अभ्यास देती है: निकाले गए टेक्स्ट को सटीक उत्तर में बदलना।
एक नजर में
- रिलीज़
- Baidu ने 27 अक्टूबर, 2026 को Unlimited OCR 2 की घोषणा की।
- फोकस
- लंबे दस्तावेज़ों की पार्सिंग, लेआउट संरचना और पृष्ठों के पार जारी रहने वाली सामग्री।
- एक्सेस
- घोषणा में मॉडल वेट और होस्ट की गई सार्वजनिक-परीक्षण सेवाओं के लिंक हैं।
Unlimited OCR 2 क्या जोड़ता है?
Baidu शीर्षकों, पैराग्राफ़ों, तालिकाओं और अन्य लेआउट तत्वों की संरचित पहचान का वर्णन करता है, जिसमें पेज ब्रेक के पार तालिकाओं और टेक्स्ट को जोड़ना शामिल है। वह इस रिलीज़ को बहुत लंबे दस्तावेज़ों के लिए प्रस्तुत करता है। Unlimited नाम असीमित होस्टेड उपयोग की गारंटी नहीं है: अपने चुने हुए मार्ग के लिए सेवा सीमाएँ और तैनाती की आवश्यकताएँ जाँचें।
स्कैन किए गए PDF से टेक्स्ट: तीन चरणों वाला वर्कफ़्लो अपनाएँ
सबसे पहले इनपुट की पहचान करें। यदि टेक्स्ट चुना नहीं जा सकता, तो OCR चरण की ज़रूरत हो सकती है। यदि चुना जा सकता है लेकिन तालिका गलत कॉलम में कॉपी होती है, तो लेआउट निष्कर्षण पर ध्यान दें। मूल पृष्ठों को निकाले गए संस्करण के साथ रखें ताकि संरचना जाँची जा सके।
दूसरा, महत्वपूर्ण विवरण जाँचें: पहचानकर्ता, तारीखें, दशमलव विभाजक, ऋण चिह्न और कॉलम शीर्षक। हर निकाली गई पंक्ति के साथ पृष्ठ संख्या बनाए रखें। कॉलम खिसकने से सही संख्या गलत दावे में बदल सकती है।
तीसरा, सहायक से केवल सत्यापित टेक्स्ट से उत्तर देने को कहें। हर महत्वपूर्ण कथन के लिए स्रोत संदर्भ और किसी फ़ील्ड के न होने पर स्पष्ट रूप से अज्ञात लिखने की शर्त रखें। प्रतिलेखन के प्रश्न को व्याख्या के प्रश्न से अलग रखें।
एकाधिक पृष्ठों वाली तालिकाओं की जांच कैसे करें
दोहराए गए हेडर लेबल हैं, अतिरिक्त डेटा पंक्तियाँ नहीं। उप-योग को उसकी मूल प्रविष्टियों में दोबारा नहीं जोड़ना चाहिए। जब कोई पंक्ति अगले पृष्ठ पर जारी रहे, तो उसे मिलाने से पहले उसका पहचानकर्ता जाँचें; दो मिलते-जुलते विवरण अलग-अलग रिकॉर्ड के हो सकते हैं।
स्प्रेडशीट में निर्यात करने से पहले मूल पंक्तियाँ गिनें, हर संख्यात्मक कॉलम की इकाई की पुष्टि करें और कम से कम एक योग की मैन्युअल रूप से तुलना करें। अनिश्चित वर्णों को अनिश्चित ही रहने दें, बजाय इसके कि सहायक से अनुमान लगाने को कहें कि स्कैन में शायद क्या लिखा था।
ज्ञात उत्तर वाला दस्तावेज़-विश्लेषण प्रॉम्प्ट आज़माएँ
यह काल्पनिक टेक्स्ट अभ्यास निष्कर्षण के बाद के तर्क को जाँचता है, OCR मॉडल को नहीं। इसमें कोई फ़ाइल अपलोड नहीं करनी है। सही परिणाम A17 = 40 इकाइयाँ और B22 = 25 इकाइयाँ है, कुल 65 इकाइयाँ। दोहराया गया शीर्षक कुछ नहीं जोड़ता, और दोनों में से किसी की भुगतान स्थिति ज्ञात नहीं है।
यदि सहायक कहता है कि चालानों का भुगतान हो चुका है, किसी पंक्ति को दोगुना करता है या शीर्षक को आइटम मानता है, तो परिणाम असफल है। किसी अन्य दस्तावेज़ में इस्तेमाल करने से पहले उससे हर पंक्ति के लिए पृष्ठ का हवाला देने को कहें।
केवल इस काल्पनिक निकाले गए दस्तावेज़ का उपयोग करें। पृष्ठ 1: शीर्षक चालान | राशि; पंक्ति A17 | 40 इकाइयाँ। पृष्ठ 2: दोहराया गया शीर्षक चालान | राशि; पंक्ति B22 | 25 इकाइयाँ। कोई भुगतान स्थिति नहीं बताई गई है। चालान आईडी, राशि, स्रोत पृष्ठ और भुगतान स्थिति वाली एक तालिका लौटाएँ। दोनों राशियों का योग एक बार करें। अनुपलब्ध भुगतान स्थिति को अज्ञात के रूप में चिह्नित करें। बताएँ कि दोहराए गए शीर्षक डेटा पंक्तियाँ क्यों नहीं हैं। भुगतान का अनुमान न लगाएँ और न ही अनुपलब्ध फ़ील्ड गढ़ें।अपने दस्तावेज़ों के लिए OCR टूल चुनना
किसी संग्रह को संसाधित करने से पहले एक प्रतिनिधि नमूना आज़माएँ: एक साफ़ पृष्ठ, एक निम्न-गुणवत्ता वाला स्कैन, एक बहु-स्तंभ पृष्ठ और पृष्ठों में बँटी एक तालिका। अपनी फ़ाइलों में प्रयुक्त भाषा और लिपि जाँचें। एक भाषा या एक साफ़ उदाहरण पर सफलता से हर दस्तावेज़ पर सटीकता सिद्ध नहीं होती।
गोपनीय सामग्री अपलोड करने से पहले जाँचें कि डेटा कहाँ प्रोसेस होगा और सेवा की डेटा संबंधी शर्तें क्या हैं। परीक्षण में काल्पनिक उदाहरण या संवेदनशील जानकारी छिपाए गए नमूने इस्तेमाल करें। खुले वेट वाले मॉडल को स्वयं चलाने और होस्टेड सेवा इस्तेमाल करने की संचालन संबंधी ज़रूरतें अलग हैं।
उपयोगी परिणाम वह ट्रेस करने योग्य डेटा है जिसे आप जाँच सकें। निष्कर्षण की गति के साथ-साथ सुधार में लगा समय और छूटी पंक्तियाँ भी मापें; तेज़ आउटपुट का कोई मूल्य नहीं यदि किसी को बाद में तालिका दोबारा बनानी पड़े।
सवाल और जवाब
क्या OCR स्वचालित रूप से एक विश्वसनीय सारांश तैयार करता है?
नहीं। OCR टेक्स्ट निकालता है; सारांश उसकी व्याख्या करता है। पहले महत्वपूर्ण स्रोत विवरण जाँचें ताकि निष्कर्षण की त्रुटियाँ आत्मविश्वास भरे निष्कर्ष न बन जाएँ।
क्या Unlimited का मतलब असीमित मुफ़्त प्रोसेसिंग है?
यहाँ ऐसी कोई सेवा गारंटी सिद्ध नहीं होती। होस्ट की गई सेवा की शर्तें या मॉडल चलाने के लिए ज़रूरी संसाधन जाँचें।
क्या GO AI उदाहरण स्कैन-PDF पहचान का परीक्षण करता है?
नहीं। यह एक अलग चरण जाँचता है: पहले से निकाले गए काल्पनिक टेक्स्ट पर तर्क करना। उत्तर कुंजी हमने लिखी है; यह किसी OCR मॉडल का रिकॉर्ड किया गया परिणाम नहीं है।
स्रोत और संपादकीय टिप्पणी
बताए तथ्यों के स्रोत लिंक दिए हैं। GO AI विश्लेषण वाले भाग हमारी व्याख्या हैं; प्रॉम्प्ट सुझाव हैं, दर्ज परीक्षण परिणाम नहीं।
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27