Actualités IA
Unlimited OCR 2 : PDF scanné en texte et extraction de tableaux
Découvrez Unlimited OCR 2 de Baidu pour convertir un PDF scanné en texte et extraire ses tableaux. Vérifiez les données avant de demander un résumé à l’IA.
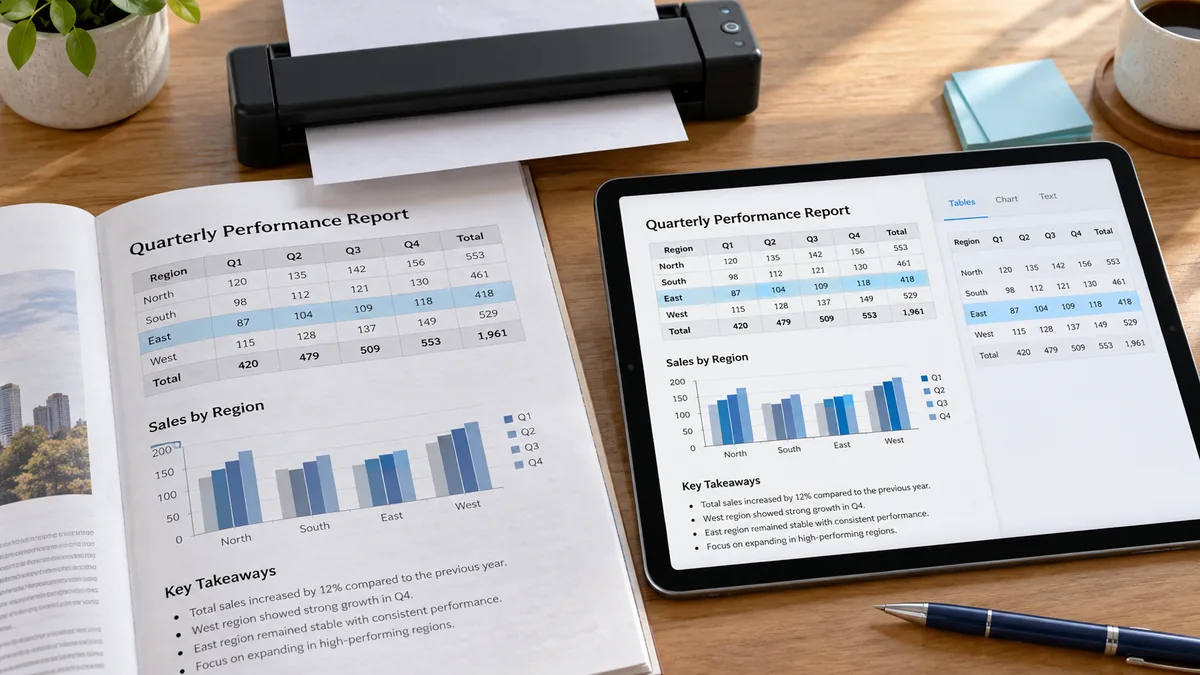
Un PDF numérisé peut vous paraître parfaitement lisible tout en étant difficile à rechercher, copier ou résumer. OCR transforme l’image de la page en texte ; l’analyse des documents ajoute une structure telle que des titres et des tableaux.
Unlimited OCR 2 est une nouvelle version de ce flux de travail. Ce guide explique l’annonce et vous propose un petit exercice vérifiable pour la prochaine étape : transformer le texte extrait en une réponse précise.
En un coup d’œil
- Lancement
- Baidu a annoncé Unlimited OCR 2 le 27 octobre 2026.
- Objectif
- Analyse de documents longs, structure de mise en page et contenu qui se poursuit sur plusieurs pages.
- Accès
- L’annonce renvoie aux poids du modèle et aux services de tests publics hébergés.
Qu’ajoute Unlimited OCR 2 ?
Baidu décrit la reconnaissance des titres, paragraphes, tableaux et autres éléments de mise en page, avec réunion des contenus coupés entre les pages. Le modèle vise les documents très longs. Le nom Unlimited ne garantit pas un usage en ligne illimité : vérifiez les limites du service et les exigences de déploiement.
Convertir un PDF scanné en texte : trois étapes
Tout d’abord, identifiez l’entrée. Si le texte ne peut pas être sélectionné, une étape OCR peut être nécessaire. S’il peut être sélectionné mais qu’un tableau est copié dans les mauvaises colonnes, concentrez-vous sur l’extraction de la mise en page. Conservez les pages originales à côté de la version extraite afin que la structure puisse être vérifiée.
Deuxièmement, inspectez les détails de grande valeur : identifiants, dates, séparateurs décimaux, signes négatifs et en-têtes de colonnes. Conservez le numéro de page avec chaque ligne extraite. Un décalage de colonne peut transformer un nombre précis en une affirmation inexacte.
Demandez ensuite à l’assistant de répondre uniquement à partir du texte vérifié. Exigez une référence pour chaque affirmation importante et la mention « inconnu » lorsqu’une donnée manque. Distinguez la transcription de l’interprétation.
Comment vérifier les tableaux qui s’étendent sur plusieurs pages
Les en-têtes répétés sont des étiquettes, pas des lignes de données supplémentaires. Un sous-total ne doit pas être ajouté à nouveau aux entrées sous-jacentes. Lorsqu’une ligne continue sur une autre page, vérifiez son identifiant avant de la fusionner ; deux descriptions similaires peuvent appartenir à des enregistrements différents.
Avant d’exporter dans un tableur, comptez les lignes d’origine, vérifiez l’unité de chaque colonne numérique et contrôlez au moins un total à la main. Signalez les caractères incertains au lieu de demander à l’assistant de deviner le contenu du scan.
Essayez un prompt d’analyse de document avec corrigé
Cet exercice de texte fictif teste le raisonnement après extraction, et non le modèle OCR lui-même. Il ne nécessite aucun envoi de fichier. Le résultat correct a A17 = 40 unités et B22 = 25 unités, soit 65 unités au total. Le titre répété n’ajoute rien et aucun des deux statuts de paiement n’est connu.
Si l’assistant dit que les factures sont payées, double une ligne ou traite l’en-tête comme un élément, le résultat échoue. Demandez-lui de citer la page pour chaque ligne avant de l’utiliser dans un autre document.
Utilisez uniquement ce document fictif déjà extrait. Page 1 : en-tête Facture | Montant ; ligne A17 | 40 unités. Page 2 : en-tête répété Facture | Montant ; ligne B22 | 25 unités. Aucun statut de paiement n’est indiqué. Produisez un tableau avec l’identifiant de facture, le montant, la page source et le statut de paiement. Additionnez les deux montants une seule fois. Indiquez « inconnu » pour le statut de paiement manquant. Expliquez pourquoi les en-têtes répétés ne sont pas des lignes de données. Ne déduisez aucun paiement et n’inventez aucun champ manquant.Choisir un outil OCR pour vos documents
Avant de traiter une archive, testez un échantillon varié : une page nette, un scan de mauvaise qualité, une page à plusieurs colonnes et un tableau réparti sur deux pages. Vérifiez la langue et le système d’écriture de vos fichiers. Un succès sur une langue ou un document net ne garantit pas la précision de tous les résultats.
Avant d’envoyer un document confidentiel, vérifiez où les données sont traitées et les conditions du service. Pour l’évaluation, utilisez des exemples fictifs ou des documents dont les informations sensibles sont masquées. Exécuter un modèle à poids ouverts et utiliser un service hébergé impliquent des contraintes différentes.
Un résultat utile est la présence de données traçables que vous pouvez vérifier. Mesurez le temps de correction et les lignes manquantes ainsi que la vitesse d’extraction ; une sortie plus rapide n’est pas utile si quelqu’un doit reconstruire le tableau par la suite.
Questions et réponses
OCR produit-il automatiquement un résumé fiable ?
Non. OCR extrait le texte ; le résumé l’interprète. Vérifiez d’abord les détails importants de la source afin que les erreurs d’extraction ne deviennent pas des conclusions sûres.
Unlimited signifie-t-il un traitement gratuit et illimité ?
Aucune garantie de service de ce type n’est établie ici. Vérifiez les conditions du service hébergé ou les ressources requises pour exécuter le modèle.
L’exemple GO AI teste-t-il la reconnaissance d’un PDF scanné ?
Non. Il teste une autre étape : raisonner sur un texte fictif déjà extrait. Nous avons rédigé le corrigé ; il ne s’agit pas d’un résultat mesuré du modèle OCR.
Sources et note éditoriale
Les faits rapportés renvoient à leurs sources. Les sections Analyse de GO AI présentent notre interprétation ; les prompts sont des suggestions, pas des résultats d’essais enregistrés.
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27