AI新闻
Unlimited OCR 2:扫描PDF转文字与跨页表格识别
了解百度 Unlimited OCR 2 如何处理长文档、扫描 PDF 和跨页表格,以及如何在让 AI 总结之前核对识别结果。
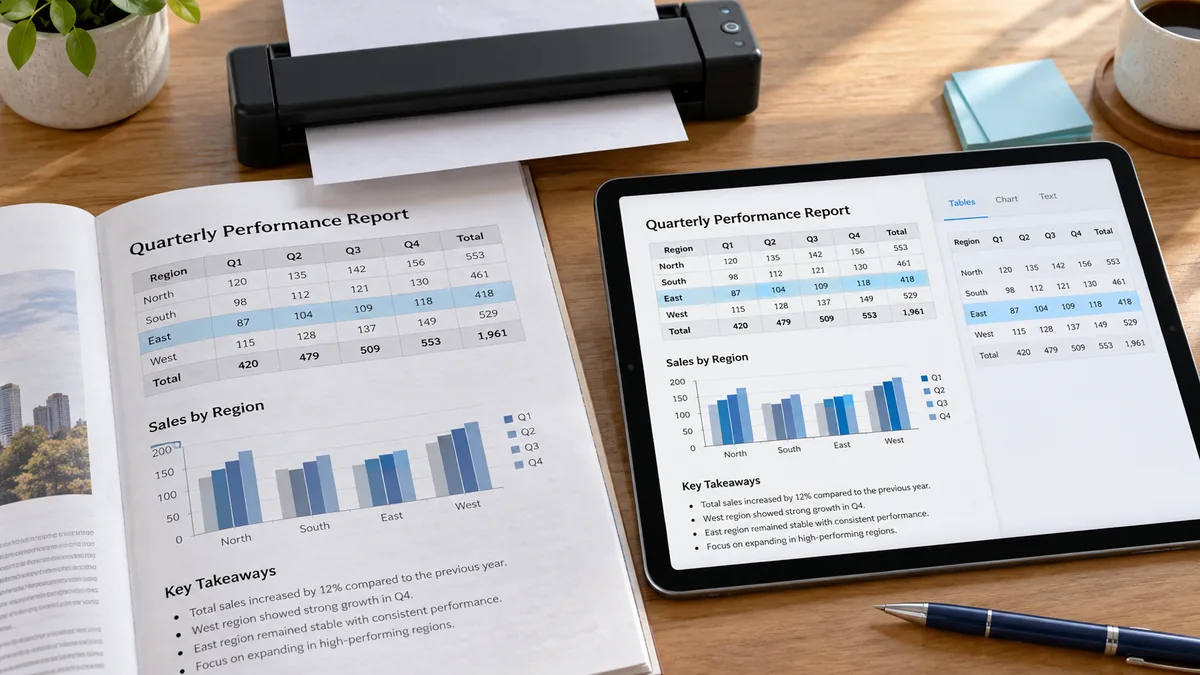
一份扫描版 PDF 在您眼里可能清清楚楚,却依然难以搜索、复制或总结。OCR 把页面图像转成文字;文档解析则在此基础上补回标题、表格等结构。
Unlimited OCR 2 是这条工作流中的新成员。本文解读这次发布,并提供一道可核对的小练习,针对的是下一步:把提取出来的文本变成准确的答案。
一览
- 发布
- 百度于 2026 年 10 月 27 日发布 Unlimited OCR 2。
- 重点
- 长文档解析、版面结构,以及跨页延续的内容。
- 获取方式
- 公告给出了模型权重和在线公测服务的链接。
Unlimited OCR 2 新增了什么?
百度介绍了对标题、段落、表格等版面元素的结构化识别,包括把跨页断开的表格和文字重新拼接起来,并把这个版本定位于超长文档。Unlimited 这个名字并不保证在线服务可以无限量使用:请按您选择的方式核对服务额度和部署要求。
扫描版 PDF 转文字:三步工作流
第一步,判断输入类型。如果文字无法选中,可能需要先做 OCR;如果能选中,但表格复制出来串了列,重点就在版面提取。把原始页面和提取结果并排放着,方便核对结构。
第二步,核对高价值细节:编号、日期、小数点、负号和列标题。每一行提取结果都带上页码。一次串列就可能让一个准确的数字变成一句错误的结论。
第三步,要求助手只根据核对过的文本作答。每一条重要表述都必须注明出处,字段缺失时要明确写“未知”。把“原文写了什么”和“原文是什么意思”这两类问题分开问。
如何核对跨页表格
重复出现的表头是标签,不是多出来的数据行。小计不应再加回到明细行上。一行延续到下一页时,先核对编号再合并;两条相似的描述可能属于不同的记录。
导出到电子表格之前,先数清原始行数,确认每个数值列的单位,并手动核对至少一个合计。不确定的字符就标为不确定,不要让助手去猜扫描件“大概”写的是什么。
试试这道有标准答案的文档分析提示词
这道虚构的文本练习测试的是提取之后的推理,而不是 OCR 模型本身,也不需要上传文件。正确结果是 A17 = 40 单位、B22 = 25 单位,合计 65 单位。重复的表头不增加任何内容,两张发票的付款状态都未知。
如果助手说发票已付款、把某一行算了两次,或者把表头当成一条记录,就算不合格。在把结果用到其他文档之前,要求它为每一行注明页码。
只使用以下这份虚构的文档提取结果。第 1 页:表头“发票 | 金额”;数据行“A17 | 40 单位”。第 2 页:重复表头“发票 | 金额”;数据行“B22 | 25 单位”。全文未注明付款状态。请输出一张包含发票编号、金额、来源页码和付款状态的表格。两笔金额只相加一次。付款状态缺失的,标为“未知”。解释为什么重复的表头不是数据行。不要推断付款情况,也不要编造缺失字段。如何为您的文档选择 OCR 工具
批量处理整个档案库之前,先拿一组有代表性的样本试一试:一页清晰的、一页低质量扫描的、一页多栏的,再加一张跨页表格。还要检查您自己文件所用的语言和文字。在某一种语言或一份清晰样本上成功,并不代表每份文档都能准确识别。
涉及机密材料时,上传前先确认处理发生在哪里,以及该服务的数据处理条款。评估工作流期间,请用虚构样本或已打码的样本。开放模型权重和托管服务是两种不同的部署选择,运维要求也各不相同。
有用的产出,是可追溯、可核对的数据。除了提取速度,也要衡量修正耗时和漏掉的行数;如果事后还得有人把表格重做一遍,出得再快也没有价值。
常见问题
OCR 会自动生成可靠的摘要吗?
不会。OCR 负责提取文字,摘要则是对文字的解读。请先核对重要的原始细节,以免提取错误变成言之凿凿的结论。
Unlimited 是指无限量免费处理吗?
本文无法确认存在这样的服务保证。请查看托管服务的条款,或自行运行模型所需的资源。
GO AI 示例测试的是扫描版 PDF 识别吗?
不是。它测试的是另一个环节:对已经提取出来的虚构文本进行推理。参考答案由我们撰写,并非某次 OCR 模型的实际输出记录。
来源与编辑说明
事实信息附有来源链接。标注“GO AI 分析”的部分包含我们的解读;提示词是建议,不是已记录的测试结果。
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27