AI 新聞
Unlimited OCR 2:掃描 PDF 轉文字、PDF 文字辨識與表格擷取
了解百度 Unlimited OCR 2 的長文件解析、掃描 PDF 轉文字與跨頁表格辨識,以及如何在請 AI 摘要前核對資料。
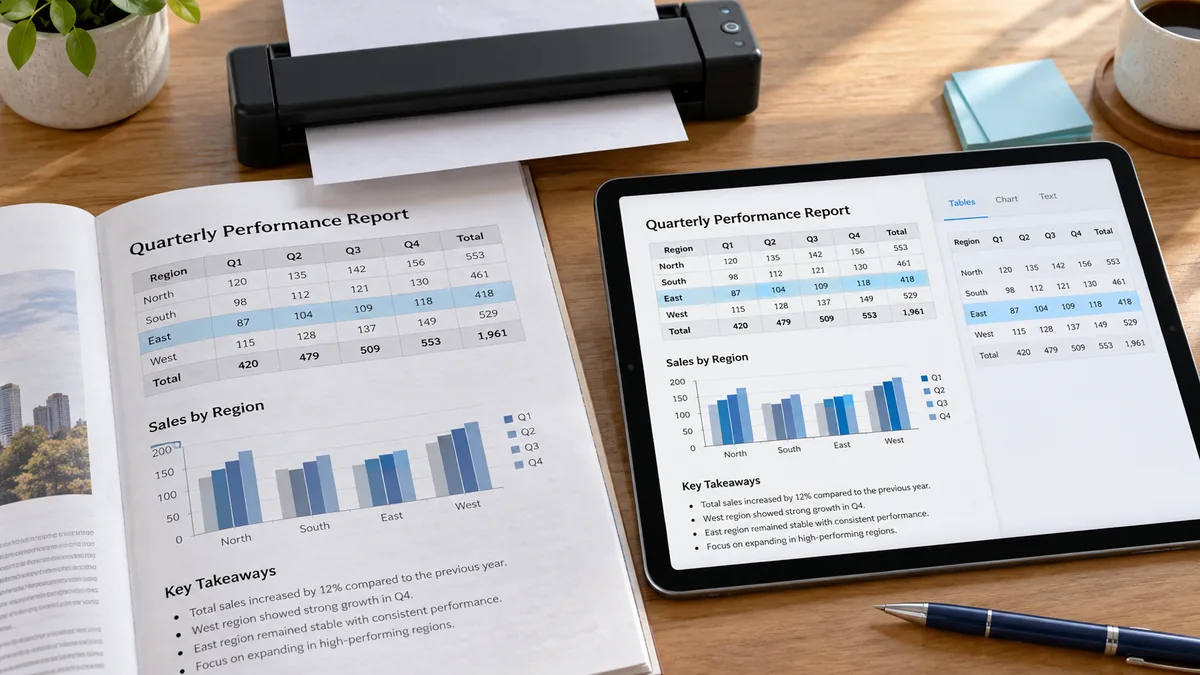
一份掃描 PDF 在您眼裡可能清清楚楚,卻依然難以搜尋、複製或摘要。OCR 把頁面影像轉成文字;文件解析則在此基礎上補回標題、表格等結構。
Unlimited OCR 2 是這條工作流程裡的新成員。本文解讀這次發表,並提供一道可核對的小練習,針對的是下一步:把擷取出來的文字變成準確的答案。
概覽
- 發表
- 百度於 2026 年 10 月 27 日發表 Unlimited OCR 2。
- 重點
- 長文件解析、版面結構,以及跨頁延續的內容。
- 取得方式
- 公告提供了模型權重和線上公開測試服務的連結。
Unlimited OCR 2 新增了什麼?
百度介紹了對標題、段落、表格等版面元素的結構化辨識,包括把跨頁斷開的表格和文字重新接起來,並將這個版本定位在超長文件。Unlimited 這個名稱並不保證線上服務可以無限量使用:請依您選擇的方式確認服務額度與部署需求。
掃描 PDF 轉文字:三步驟工作流程
第一步,判斷輸入類型。如果文字無法選取,可能需要先做 OCR;如果選得到,但表格複製出來欄位錯位,重點就在版面擷取。把原始頁面和擷取結果並排放著,方便核對結構。
第二步,核對高價值細節:編號、日期、小數點、負號和欄位標題。每一列擷取結果都帶上頁碼。一次錯欄就可能讓一個準確的數字變成一句錯誤的結論。
第三步,要求助理只根據核對過的文字作答。每一條重要敘述都必須註明出處,欄位缺漏時要明確寫「未知」。把「原文寫了什麼」和「原文是什麼意思」這兩類問題分開問。
如何核對跨頁表格
重複出現的表頭是標籤,不是多出來的資料列。小計不應再加回明細列上。一列延續到下一頁時,先核對編號再合併;兩筆相似的描述可能屬於不同的紀錄。
匯出到試算表之前,先數清原始列數,確認每個數值欄的單位,並手動核對至少一個合計。不確定的字元就標為不確定,不要讓助理去猜掃描檔「大概」寫的是什麼。
試試這道有標準答案的文件分析提示詞
這道虛構的文字練習測試的是擷取之後的推理,而不是 OCR 模型本身,也不需要上傳檔案。正確結果是 A17 = 40 單位、B22 = 25 單位,合計 65 單位。重複的表頭不增加任何內容,兩張發票的付款狀態都未知。
如果助理說發票已付款、把某一列算了兩次,或者把表頭當成一筆項目,就算不合格。在把結果用到其他文件之前,要求它為每一列註明頁碼。
只使用以下這份虛構的文件擷取結果。第 1 頁:表頭「發票 | 金額」;資料列「A17 | 40 單位」。第 2 頁:重複表頭「發票 | 金額」;資料列「B22 | 25 單位」。全文未註明付款狀態。請輸出一張包含發票編號、金額、來源頁碼與付款狀態的表格。兩筆金額只相加一次。付款狀態缺漏的,標為「未知」。解釋為什麼重複的表頭不是資料列。不要推斷付款情況,也不要編造缺漏欄位。如何為您的文件選擇 OCR 工具
大量處理整批檔案之前,先拿一組有代表性的樣本試試:一頁清晰的、一頁低品質掃描的、一頁多欄的,再加一張跨頁表格。也要檢查您自己檔案所用的語言和文字。在某一種語言或一份清晰樣本上成功,並不代表每份文件都能準確辨識。
涉及機密資料時,上傳前先確認處理發生在哪裡,以及該服務的資料處理條款。評估工作流程期間,請用虛構樣本或已遮蔽敏感內容的樣本。開放模型權重和託管服務是兩種不同的部署選擇,維運需求也各不相同。
有用的產出,是可追溯、可核對的資料。除了擷取速度,也要衡量修正耗時和漏掉的列數;如果事後還得有人把表格重做一遍,出得再快也沒有價值。
常見問題解答
OCR 會自動產生可靠的摘要嗎?
不會。OCR 負責擷取文字,摘要則是對文字的解讀。請先核對重要的原始細節,以免擷取錯誤變成言之鑿鑿的結論。
Unlimited 是指無限量免費處理嗎?
本文無法確認有這樣的服務保證。請查看託管服務的條款,或自行執行模型所需的資源。
GO AI 範例測試的是掃描 PDF 辨識嗎?
不是。它測試的是另一個環節:對已經擷取出來的虛構文字進行推理。參考答案由我們撰寫,並非某次 OCR 模型的實際輸出紀錄。
來源與編者註
報告的事實與其來源相關聯。標記為 GO AI 分析的部分包含我們的解釋;提示詞只是建議,並非記錄的測試結果。
- 百度:Unlimited OCR 2 發表與公開測試 — 2026-10-27