KI-News
Unlimited OCR 2: Gescannte PDF in Text und Tabellen umwandeln
Baidus Unlimited OCR 2 für lange Dokumente, gescannte PDF und Tabellen: So prüfst du extrahierte Daten, bevor du KI um eine Zusammenfassung bittest.
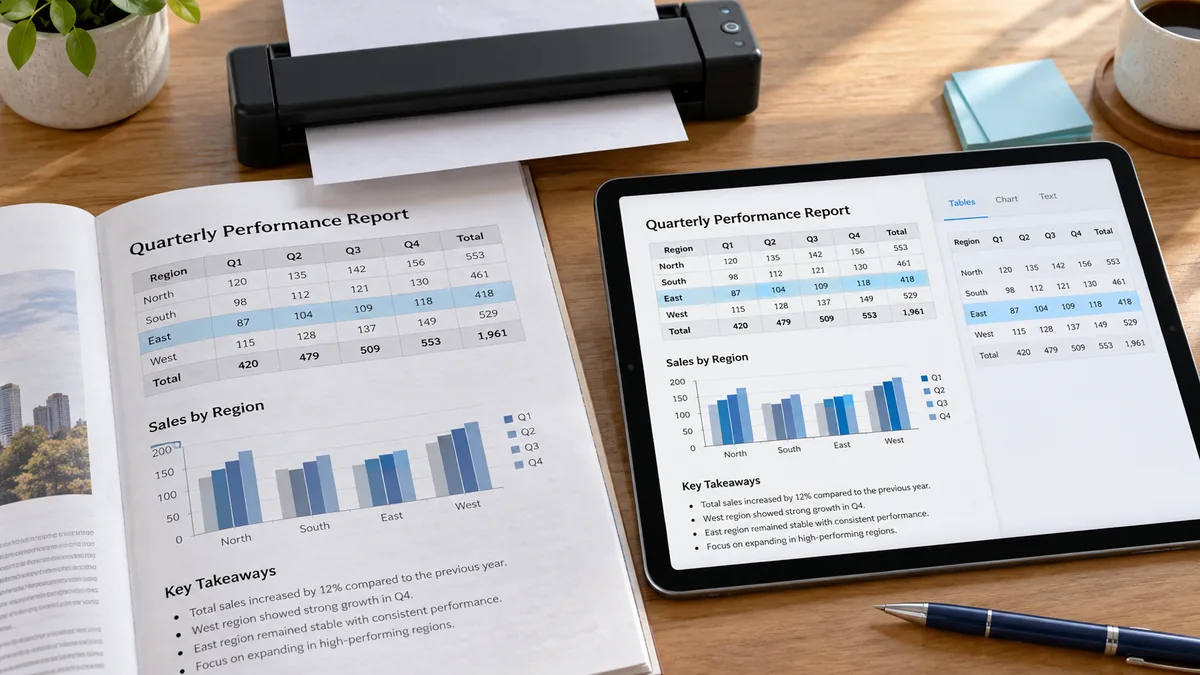
Eine gescannte PDF kann gut lesbar wirken und trotzdem schwer durchsuchbar, kopierbar oder zusammenzufassen sein. OCR macht aus dem Seitenbild Text; Dokumentanalyse ergänzt Überschriften und Tabellenstrukturen.
Unlimited OCR 2 ist ein neuer Release für diesen Ablauf. Wir erklären die Ankündigung und geben eine kleine überprüfbare Übung für den nächsten Schritt: eine korrekte Antwort aus extrahiertem Text.
Auf einen Blick
- Veröffentlichung
- Baidu kündigte Unlimited OCR 2 am 27. Oktober 2026 an.
- Schwerpunkt
- Lange Dokumente, Layoutstruktur und Inhalte über Seitengrenzen hinweg.
- Zugang
- Die Ankündigung verlinkt Modellgewichte und gehostete öffentliche Testangebote.
Was ergänzt Unlimited OCR 2?
Baidu beschreibt strukturierte Erkennung von Überschriften, Absätzen und Tabellen sowie deren Zusammenführung über Seitenwechsel hinweg. Der Release zielt auf sehr lange Dokumente. Unlimited garantiert aber keine unbegrenzte Onlinenutzung: Prüfe Dienstlimits und Betriebsanforderungen.
Gescannte PDF in Text: drei Arbeitsschritte
Bestimme zuerst den Eingabetyp. Nicht auswählbarer Text kann OCR erfordern. Lässt sich Text auswählen, aber die Tabelle landet in falschen Spalten, prüfe die Layoutextraktion. Halte Originalseiten und extrahierte Fassung zum Strukturvergleich nebeneinander.
Prüfe danach Kennungen, Daten, Dezimaltrennzeichen, Minuszeichen und Spaltenüberschriften. Bewahre die Quellseite jeder Zeile. Eine verschobene Spalte macht aus einer korrekten Zahl eine falsche Aussage.
Lass den Assistenten schließlich nur aus dem geprüften Text antworten. Verlange für wichtige Aussagen Quellenverweise und bei fehlenden Angaben ausdrücklich unbekannt. Trenne Abschrift und Interpretation.
Tabellen über mehrere Seiten prüfen
Wiederholte Überschriften sind Beschriftungen, keine zusätzlichen Datenzeilen. Addiere eine Zwischensumme nicht nochmals zu ihren Einzelposten. Prüfe beim Zusammenführen fortgesetzter Zeilen die Kennung: Ähnliche Beschreibungen können zu unterschiedlichen Datensätzen gehören.
Zähle vor dem Tabellenexport die ursprünglichen Zeilen, prüfe die Einheit jeder Zahlenspalte und rechne mindestens eine Summe nach. Lass unklare Zeichen unklar, statt ihre Bedeutung erraten zu lassen.
Dokumentanalyse mit bekannter Lösung ausprobieren
Die fiktive Textübung prüft das Denken nach der Extraktion, nicht das OCR-Modell. Ein Upload ist unnötig. Richtig sind A17 = 40 Einheiten, B22 = 25 und insgesamt 65. Die wiederholte Überschrift wird nicht mitgerechnet; beide Zahlungsstatus sind unbekannt.
Erklärt der Assistent die Rechnungen für bezahlt, verdoppelt eine Zeile oder zählt eine Überschrift als Posten, ist das Ergebnis falsch. Verlange die Quellseite für jede Zeile, bevor du sie weiterverwendest.
Nutze nur dieses fiktive extrahierte Dokument. Seite 1: Überschrift Rechnung | Betrag; Zeile A17 | 40 Einheiten. Seite 2: wiederholte Überschrift Rechnung | Betrag; Zeile B22 | 25 Einheiten. Ein Zahlungsstatus ist nicht angegeben. Erstelle eine Tabelle mit Rechnungs-ID, Betrag, Quellseite und Zahlungsstatus. Addiere beide Beträge jeweils einmal. Markiere den fehlenden Zahlungsstatus als unbekannt. Erkläre, warum wiederholte Überschriften keine Datenzeilen sind. Unterstelle keine Zahlung und erfinde keine fehlenden Angaben.Ein OCR-Werkzeug für deine Dokumente auswählen
Teste vor einem ganzen Archiv eine saubere Seite, einen schlechten Scan, ein mehrspaltiges Dokument und eine geteilte Tabelle. Prüfe Sprache und Schrift deiner Dateien. Erfolg bei einer Sprache oder sauberen Vorlage beweist keine allgemeine Genauigkeit.
Prüfe bei vertraulichen Inhalten vor dem Upload Verarbeitungsort und Datenschutzbedingungen. Nutze für die Erprobung fiktive oder geschwärzte Beispiele. Offene Gewichte und ein gehosteter Dienst sind unterschiedliche Betriebswege mit unterschiedlichen Anforderungen.
Nützlich sind nachvollziehbare Daten, die du kontrollieren kannst. Miss neben Geschwindigkeit auch Korrekturzeit und fehlende Zeilen. Schnelle Ausgabe hilft nicht, wenn jemand die Tabelle neu aufbauen muss.
Fragen und Antworten
Liefert OCR automatisch eine zuverlässige Zusammenfassung?
Nein. OCR extrahiert Text, eine Zusammenfassung interpretiert ihn. Prüfe wichtige Details zuerst, damit Erkennungsfehler nicht zu selbstsicheren Schlussfolgerungen werden.
Bedeutet Unlimited unbegrenzte kostenlose Verarbeitung?
Eine solche Garantie ist hier nicht belegt. Prüfe die Dienstbedingungen oder die für den Modellbetrieb erforderlichen Ressourcen.
Testet das GO-AI-Beispiel die Erkennung gescannter PDF?
Nein. Es prüft einen separaten Schritt: Schlussfolgern aus bereits extrahiertem fiktivem Text. Die Musterlösung stammt von uns, nicht aus einem aufgezeichneten OCR-Modelllauf.
Quellen und redaktioneller Hinweis
Berichtete Fakten sind mit ihren Quellen verlinkt. Abschnitte mit der Kennzeichnung GO-AI-Analyse enthalten unsere Einschätzung; Prompts sind Vorschläge und keine aufgezeichneten Testergebnisse.
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27