RAG 是什麼?讓 AI 參考文件回答問題
RAG 會先找出相關資料,再讓 AI 參考內容回答。它能幫助答案連結到來源,但仍需要檢查引述、資料是否過時與回答有沒有超出依據。
RAG — 擷取增強產生 — 表示 AI 在回答之前先找一些內容。系統不是從訓練中回憶,而是搜尋你的檔案,將最相關的段落放在模型前面,並要求模型從這些段落中回答,並引用回源。它解決了訓練截止、「它從未見過我的檔案」問題以及大部分自信的發明。它並不能解決所有問題。
正確表述的問題
實際上,語言模型是對其一次讀取的大量文字的非常好的壓縮。這賦予了它流暢性和廣度,也帶來了三個具體的弱點:它在訓練截止後就不再瞭解事物,它從未見過任何私人的東西,當它不知道某些東西時,它無論如何都會產生一個合理的答案,因為產生合理的文字就是整個工作。
您無法在每次撰寫檔案時重新訓練模型。因此,您可以更改答案來自的。
四個步驟
- 索引。 您的檔案被分成多個段落 - 每個段落幾個段落 - 每個段落都轉換為捕獲其含義的數字表示形式。這種情況預先發生一次。
- 檢索。 您的問題以相同的方式轉換,系統會找到與其意義最接近的段落。不是關鍵字匹配:“關於延遲交貨,我們同意什麼”可以找到一個寫著“發貨延遲”的段落,並且從不使用您的話。
- 增強。 這些段落與您的問題以及所提供資料中的回答說明一起放入模型的上下文中。
- 產生並引用。 模型編寫答案,並且由於系統知道給出了哪些段落,因此它可以將每個宣告指向其來源。
就是這樣。巧妙的部分是第2步;值得信賴的部分是步驟 4。
為什麼「貼在聊天中」不是一回事
將檔案附加到對話中會將整個內容放入該對話的模型上下文中。這對於一篇論文來說效果很好。當它們有 90 個時,當你下個月也會問問題時,或者當相關段落位於第 340 頁而周圍的 339 頁是爭奪模型注意力的噪音時,它就會停止工作。
RAG 索引一次並依問題擷取。您一次性支付設定費用,然後無限期地詢問整個集合。我們在 GPT-5 與 Gemini 中更深入地討論了權衡 — 大上下文模型縮小了單個檔案的差距,但沒有縮小您返回的集合的差距。
RAG 仍然失敗
值得精確,因為「接地」被用作「正確」的意思:
- 檢索失敗。 如果未檢索到正確的段落,則模型會根據給出的 給出答案 — 自信但錯誤。需要綜合許多分散段落的問題(「2023 年和 2026 年政策之間發生了什麼變化?」)是典型的難題。
- 答案超出了證據。 提交相關段落的模型仍然可以新增該段落不支援的看似合理的句子。這就是引用所捕捉的內容,也是為什麼引用的答案中未引用的主張值得懷疑。
- 來源錯誤。 接地意味著忠於你的檔案,而不是忠於現實。給它一份過時的合同,你就會得到過時的答案,並且被正確引用。
- 分塊人工製品。 跨越兩個段落的表格,或者其意義取決於四十頁前的定義的子句,檢索效果很差。跨區塊的結構是整個方法的弱點。
第二個背後的一般機製本身就值得理解-看看為什麼人工智慧會編造事情。
當值得設定時
| 情況 | 使用 |
|---|---|
| 一份檔案,一個問題 | 將其貼到聊天中 |
| 您將重複查詢的一份長檔案 | 要麼,傾斜 RAG |
| 一個主題有數十個檔案 | RAG |
| 其他人會依賴的答案 | RAG — 用於引用,而非檢索 |
| 混合媒體:PDF、影片、音訊、網頁 | RAG,如果它處理所有這些 |
| 一般知識問題 | 都不是 — 只要詢問模型 |
這個產品是什麼樣子的
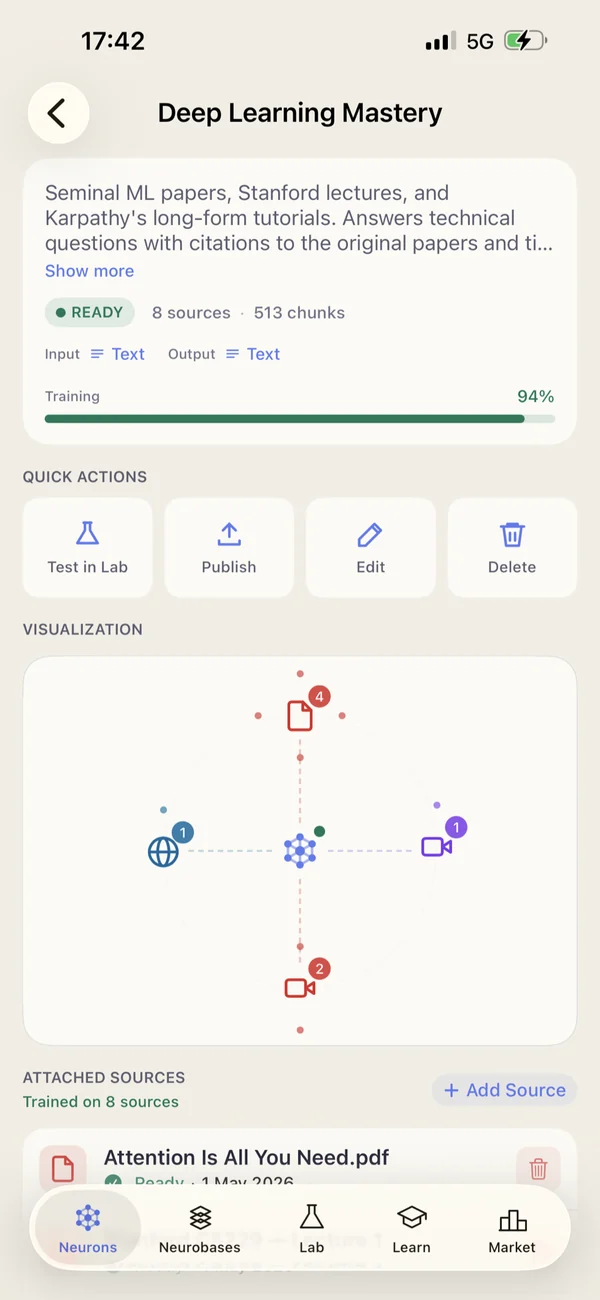
Neurobase 是我們的版本:你給一個 神經元 來源 — PDF、文字檔、影片、 YouTube、網頁、影像、音訊——並將它們索引到一個專注的助手中,並透過引用原始資料進行回答。答案可以在 Lab 在您依賴它們之前,多個神經元可以透過匯總、比較、提取和翻譯等操作連結到一個工作流程中。
如果您想要具體版本而不是概念,請從將 PDF 資料夾變成助手開始。
常見問題解答
RAG 是什麼?
檢索增強生成:系統首先搜尋您的檔案,將相關段落放入模型的上下文中,並要求它透過引用來回答這些段落。
它解決了什麼問題?
訓練截止點、模型從未見過的私人檔案以及自信的發明。引用讓你檢查而不是信任。
與上傳檔案到聊天機器人一樣嗎?
否。附加檔案適用於一次對話中的一個檔案。 RAG 對集合進行一次索引,並在多個對話中檢索每個問題。
RAG 會阻止人工智慧編造事情嗎?
它大大減少了它,但不是完全減少。檢索可能會失敗,答案可能會偏離證據,來源也可能是錯誤的。引用使這些失敗變得可以檢查。