Новини ШІ
Unlimited OCR 2: сканований PDF у текст і розпізнавання таблиць
Можливості Unlimited OCR 2 від Baidu для довгих документів, тексту й таблиць зі сканованих PDF. Як перевірити дані перед підсумком ШІ.
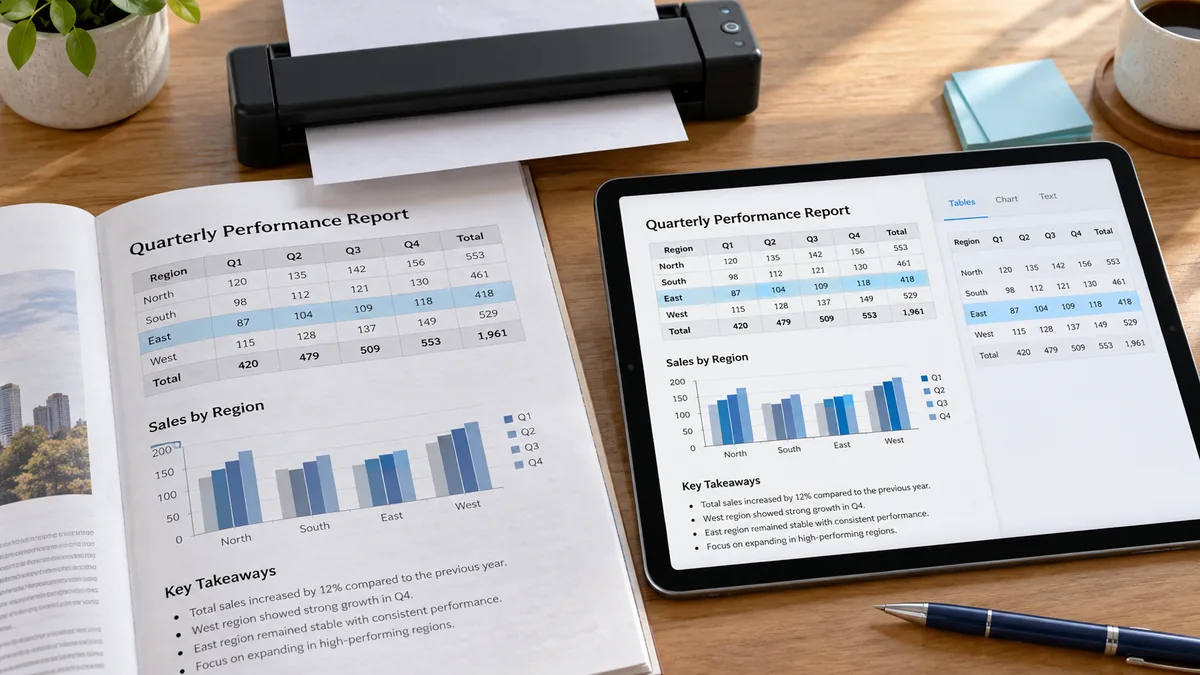
Сканований PDF може легко читатися, але погано піддаватися пошуку, копіюванню чи підсумовуванню. OCR перетворює зображення сторінки на текст, а аналіз структури документа виділяє заголовки й таблиці.
Unlimited OCR 2 — новий випуск для такого процесу. Ми пояснюємо оголошення й пропонуємо перевірювану вправу для наступного кроку: отримання правильної відповіді з витягнутого тексту.
Коротко
- Випуск
- Baidu оголосила Unlimited OCR 2 27 жовтня 2026 року.
Джерела: Baidu: випуск Unlimited OCR 2 та відкрите тестування
- Призначення
- Розбір довгих документів, їхньої структури та вмісту, що продовжується на інших сторінках.
Джерела: Baidu: випуск Unlimited OCR 2 та відкрите тестування
- Доступ
- Оголошення містить посилання на ваги моделі та онлайн-сервіси публічного тестування.
Джерела: Baidu: випуск Unlimited OCR 2 та відкрите тестування
Що додає Unlimited OCR 2?
Baidu описує розпізнавання заголовків, абзаців, таблиць та інших елементів, зокрема об’єднання тексту й таблиць через розриви сторінок. Реліз орієнтований на дуже довгі документи. Назва Unlimited не гарантує необмеженого використання онлайн-сервісу: перевіряйте його ліміти й вимоги до запуску.
Джерела: Baidu: випуск Unlimited OCR 2 та відкрите тестування
Сканований PDF у текст: три етапи роботи
Спочатку визначте тип вхідних даних. Якщо текст не виділяється, може знадобитися OCR. Якщо виділяється, але таблиця копіюється з переплутаними стовпцями, перевіряйте структуру. Тримайте оригінал поруч із витягнутими даними.
Далі перевірте ідентифікатори, дати, десяткові роздільники, мінуси та назви стовпців. Зберігайте номер сторінки кожного рядка. Зсув стовпця може перетворити правильне число на хибне твердження.
Потім попросіть асистента відповідати лише за перевіреним текстом, наводити джерело важливих тверджень і позначати відсутні дані як невідомі. Відокремлюйте переписування від тлумачення.
Як перевіряти таблиці на кількох сторінках
Повторені заголовки — це назви, а не нові рядки даних. Проміжний підсумок не додають повторно до складових. Перед об’єднанням рядків на різних сторінках звірте їхні ідентифікатори: подібні описи можуть стосуватися різних записів.
Перед експортом у таблицю порахуйте вихідні рядки, перевірте одиниці числових стовпців і вручну звірте хоча б один підсумок. Нерозбірливі символи залишайте невизначеними, не просіть модель вгадувати.
Промпт для аналізу документа з відомою відповіддю
Вигадана текстова вправа перевіряє міркування після витягування даних, а не саму OCR-модель. Завантажувати файл не потрібно. Правильні значення: A17 = 40 одиниць, B22 = 25, разом 65. Повторений заголовок нічого не додає; стан оплати обох рахунків невідомий.
Якщо асистент називає рахунки оплаченими, дублює рядок чи рахує заголовок як позицію, відповідь неправильна. Перед використанням даних вимагайте номер джерельної сторінки для кожного рядка.
Використовуй лише цей вигаданий витяг із документа. Сторінка 1: заголовок Рахунок | Сума; рядок A17 | 40 одиниць. Сторінка 2: повторений заголовок Рахунок | Сума; рядок B22 | 25 одиниць. Стан оплати не вказано. Створи таблицю з номером рахунку, сумою, сторінкою джерела та станом оплати. Додай дві суми лише один раз. Відсутній стан оплати познач як невідомий. Поясни, чому повторені заголовки не є даними. Не роби висновків про оплату й не вигадуй поля.Як обрати OCR-інструмент для своїх документів
Перед обробкою архіву перевірте чисту сторінку, неякісний скан, багатоколонкову сторінку й таблицю з розривом. Врахуйте мову та письмо своїх файлів. Успіх на чистому прикладі чи одній мові не гарантує точності на всіх документах.
Перед завантаженням конфіденційних матеріалів перевірте місце обробки й умови роботи з даними. Для оцінювання використовуйте вигадані або знеособлені приклади. Відкриті ваги й онлайн-сервіс — різні способи розгортання з різними вимогами.
Корисний результат — це дані з простежуваним джерелом. Вимірюйте час виправлень і кількість пропущених рядків, а не лише швидкість витягування. Швидкий результат не допоможе, якщо таблицю доведеться перебудовувати.
Відповіді на запитання
Чи OCR автоматично створює надійний підсумок?
Ні. OCR витягує текст, а підсумовування його тлумачить. Спочатку перевірте ключові деталі, щоб помилки розпізнавання не перетворилися на впевнені висновки.
Чи Unlimited означає необмежену безкоштовну обробку?
Такої гарантії тут немає. Перевірте умови онлайн-сервісу або ресурси, потрібні для запуску моделі.
Чи приклад GO AI перевіряє розпізнавання сканованого PDF?
Ні. Він перевіряє окремий етап — міркування над уже витягнутим вигаданим текстом. Еталонну відповідь написали ми; це не зафіксований результат OCR-моделі.
Джерела та редакційна примітка
Повідомлені факти пов’язані з їхніми джерелами. Розділи з позначкою GO AI аналіз містять нашу інтерпретацію; підказки є пропозиціями, а не записаними результатами тесту.
- Baidu: випуск Unlimited OCR 2 та відкрите тестування — 2026-10-27