Новости ИИ
Unlimited OCR 2: скан PDF в текст и распознавание таблиц
Unlimited OCR 2 от Baidu: распознавание текста и таблиц в сканах PDF и длинных документах. Как проверить данные перед подготовкой краткого пересказа с ИИ.
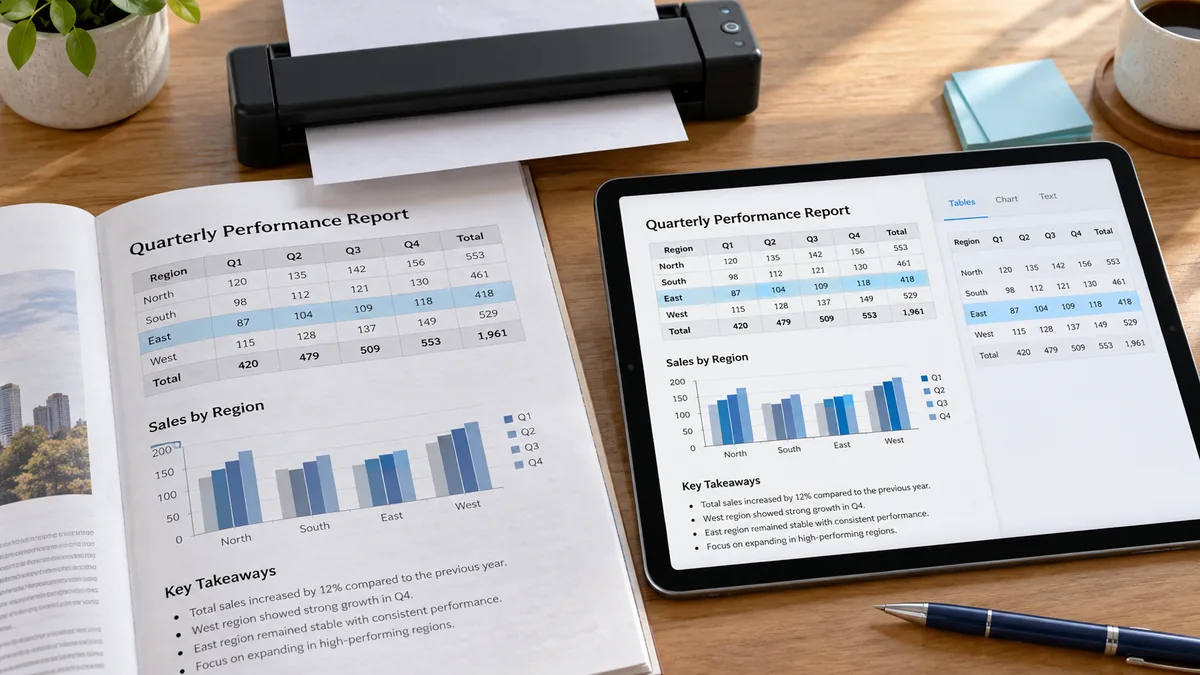
Отсканированный PDF может выглядеть вполне читаемым, но при этом в нём сложно искать, копировать или кратко пересказывать текст. OCR превращает изображение страницы в текст; разбор документа добавляет структуру, например заголовки и таблицы.
Unlimited OCR 2 — новый релиз в этом рабочем процессе. В этом руководстве объясняется анонс и предлагается небольшое проверяемое упражнение для следующего шага: превращения извлечённого текста в точный ответ.
Обзор
- Релиз
- 27 октября 2026 г. Baidu анонсировала Unlimited OCR 2.
- Фокус
- Разбор длинных документов, структура макета и содержимое с продолжением на следующих страницах.
- Доступ
- В анонсе даны ссылки на веса модели и размещённые сервисы публичного тестирования.
Что добавляет Unlimited OCR 2?
Baidu описывает структурированное распознавание заголовков, абзацев, таблиц и других элементов макета, включая объединение таблиц и текста, разорванных границей страницы. Релиз позиционируется для очень длинных документов. Название Unlimited не гарантирует безлимитного использования размещённого сервиса: проверяйте ограничения сервиса и требования к развёртыванию для выбранного способа.
Скан PDF в текст: используйте трёхэтапный рабочий процесс
Сначала определите, что на входе. Если текст нельзя выделить, может понадобиться шаг OCR. Если выделить можно, но таблица копируется не в те столбцы, сосредоточьтесь на извлечении макета. Держите исходные страницы рядом с извлечённой версией, чтобы можно было проверить структуру.
Во-вторых, проверьте важные детали: идентификаторы, даты, десятичные разделители, знаки минус и заголовки столбцов. Сохраняйте номер страницы для каждой извлечённой строки. Сдвиг столбца может превратить точное число в неверное утверждение.
В-третьих, попросите ассистента отвечать только по проверенному тексту. Требуйте ссылку на источник для каждого важного утверждения и явное «неизвестно», если поле отсутствует. Отделяйте вопрос о транскрипции от вопроса об интерпретации.
Как проверять таблицы, занимающие несколько страниц
Повторяющиеся заголовки — это подписи, а не дополнительные строки данных. Промежуточный итог нельзя прибавлять ещё раз к строкам, из которых он сложен. Когда строка переходит на другую страницу, проверьте её идентификатор перед объединением; два похожих описания могут относиться к разным записям.
Перед экспортом в электронную таблицу подсчитайте исходные строки, подтвердите единицу измерения для каждого числового столбца и сверьте хотя бы один итог вручную. Оставляйте неуверенно распознанные символы помеченными как неуверенные, а не просите ассистента угадать, что, вероятно, было в скане.
Попробуйте промпт для анализа документа с известным ответом
Это вымышленное текстовое упражнение проверяет рассуждение после извлечения, а не саму модель OCR. Оно не требует загрузки файла. Правильный результат: A17 = 40 единиц и B22 = 25 единиц, итого 65 единиц. Повторяющийся заголовок ничего не добавляет, и ни один из статусов оплаты не известен.
Если ассистент говорит, что счета оплачены, удваивает строку или считает заголовок записью, результат не засчитывается. Попросите его указать страницу для каждой строки, прежде чем использовать её в другом документе.
Используйте только этот вымышленный извлечённый документ. Страница 1: заголовок Счёт | Сумма; строка A17 | 40 единиц. Страница 2: повторяющийся заголовок Счёт | Сумма; строка B22 | 25 единиц. Статус оплаты не указан. Верните таблицу с идентификатором счёта, суммой, исходной страницей и статусом оплаты. Сложите две суммы один раз. Отметьте отсутствующий статус оплаты как неизвестный. Объясните, почему повторяющиеся заголовки не являются строками данных. Не делайте выводов об оплате и не выдумывайте недостающие поля.Выбор инструмента OCR для ваших документов
Перед обработкой архива проверьте разные образцы: чёткую страницу, плохой скан, многоколоночную страницу и таблицу с продолжением на другой странице. Учитывайте язык и систему письма ваших файлов. Успех на одном языке или на чистом образце не гарантирует точности на всех документах.
Перед загрузкой конфиденциальных материалов проверьте место обработки и условия использования данных. Для оценки берите вымышленные примеры или документы со скрытыми чувствительными сведениями. Самостоятельный запуск модели с открытыми весами и размещённый сервис требуют разной инфраструктуры и сопровождения.
Полезный результат — прослеживаемые данные, которые можно проверить. Измеряйте время на исправления и число пропущенных строк, а не только скорость извлечения; быстрый вывод бесполезен, если кому-то потом придётся заново собирать таблицу.
Вопросы и ответы
Создаёт ли OCR достоверную сводку автоматически?
Нет. OCR извлекает текст; резюмирование его интерпретирует. Сначала проверьте важные детали источника, чтобы ошибки извлечения не превратились в уверенные выводы.
Означает ли Unlimited неограниченную бесплатную обработку?
Такой гарантии сервиса здесь нет. Проверьте условия размещённого сервиса или ресурсы, необходимые для запуска модели.
Проверяет ли пример GO AI распознавание отсканированных PDF?
Нет. Он проверяет отдельный шаг: рассуждение над уже извлечённым вымышленным текстом. Ключ ответов написан нами; это не зафиксированный результат модели OCR.
Источники и редакционное примечание
Для приведённых фактов указаны источники. Разделы «Анализ GO AI» содержат нашу интерпретацию; промпты являются предложениями, а не результатами проведённых тестов.
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27