এআই সংবাদ
Unlimited OCR 2: স্ক্যান করা পিডিএফ থেকে টেক্সট ও টেবিল
দীর্ঘ নথি ও স্ক্যান করা পিডিএফ থেকে টেক্সট এবং টেবিল বের করতে Baidu-এর Unlimited OCR 2 সম্পর্কে জানুন। এআইকে সারাংশ দিতে বলার আগে তথ্য যাচাই করুন।
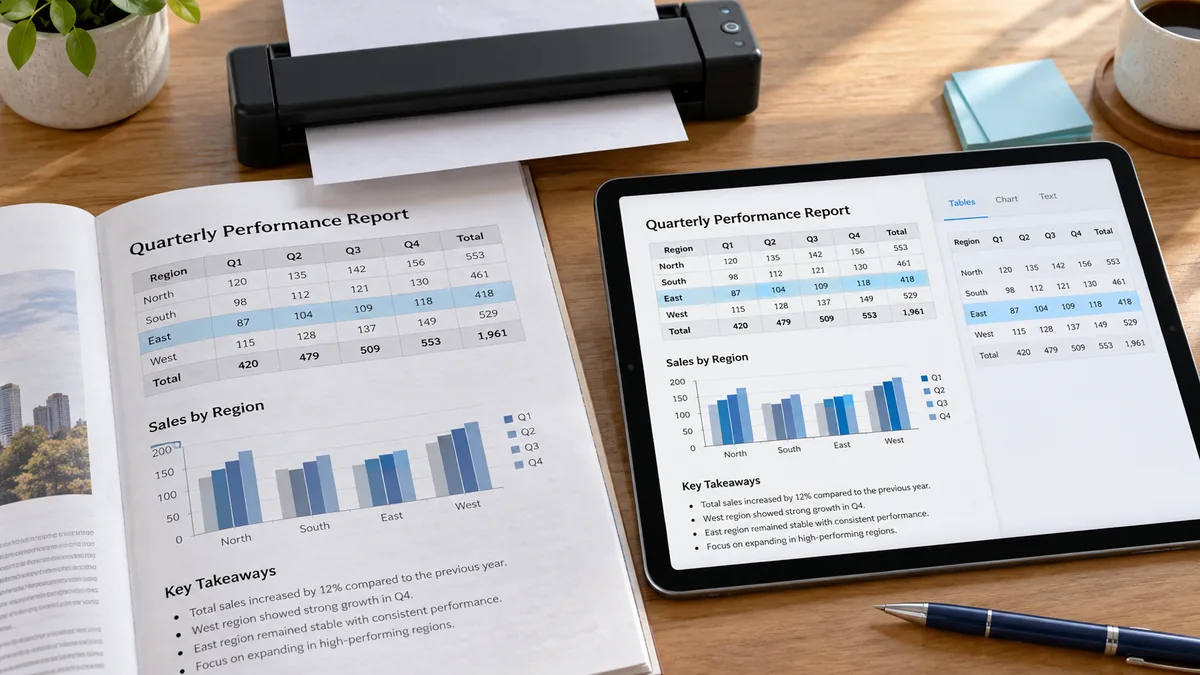
স্ক্যান করা PDF আপনার চোখে পুরোপুরি পাঠযোগ্য মনে হলেও তাতে খোঁজা, কপি করা বা সারাংশ করা কঠিন হতে পারে। OCR পৃষ্ঠার ছবিকে টেক্সটে রূপান্তর করে; ডকুমেন্ট পার্সিং তাতে শিরোনাম ও টেবিলের মতো কাঠামো যোগ করে।
Unlimited OCR 2 সেই কর্মপ্রবাহেরই একটি নতুন রিলিজ। এই নির্দেশিকায় ঘোষণাটি ব্যাখ্যা করা হয়েছে এবং পরের ধাপের জন্য একটি ছোট, যাচাইযোগ্য অনুশীলন দেওয়া হয়েছে: বের করা টেক্সট থেকে সঠিক উত্তরে পৌঁছানো।
এক নজরে
- রিলিজ
- Baidu 27 অক্টোবর, 2026-এ Unlimited OCR 2 ঘোষণা করেছে।
- ফোকাস
- দীর্ঘ নথির পার্সিং, লেআউটের কাঠামো এবং একাধিক পৃষ্ঠাজুড়ে চলা বিষয়বস্তু।
- অ্যাক্সেস
- ঘোষণায় মডেলের ওয়েট এবং হোস্ট করা পাবলিক-টেস্ট পরিষেবার লিঙ্ক দেওয়া আছে।
Unlimited OCR 2 কী যোগ করে?
Baidu শিরোনাম, অনুচ্ছেদ, টেবিল ও অন্যান্য লেআউট উপাদানের কাঠামোবদ্ধ শনাক্তকরণের কথা বলেছে, যার মধ্যে পৃষ্ঠা-বিরতির দুই পাশে ভাগ হয়ে যাওয়া টেবিল ও টেক্সট জোড়া লাগানোও আছে। রিলিজটি খুব দীর্ঘ নথির জন্য উপস্থাপন করা হয়েছে। Unlimited নামটি সীমাহীন হোস্টেড ব্যবহারের নিশ্চয়তা নয়: আপনার বেছে নেওয়া পথের জন্য পরিষেবার সীমা ও ডিপ্লয়মেন্টের শর্ত যাচাই করুন।
স্ক্যান করা পিডিএফ থেকে টেক্সট: তিন ধাপের কর্মপ্রবাহ ব্যবহার করুন
প্রথমে ইনপুটটি চিনে নিন। টেক্সট সিলেক্ট করা না গেলে OCR ধাপ লাগতে পারে। সিলেক্ট করা গেলেও যদি টেবিল ভুল কলামে কপি হয়, তবে লেআউট ঠিক রেখে টেক্সট বের করার দিকে মনোযোগ দিন। কাঠামো মিলিয়ে দেখার জন্য মূল পৃষ্ঠাগুলি বের করা সংস্করণের পাশে রাখুন।
দ্বিতীয়ত, বেশি গুরুত্বপূর্ণ বিবরণগুলি খুঁটিয়ে দেখুন: শনাক্তকারী নম্বর, তারিখ, দশমিক চিহ্ন, ঋণাত্মক চিহ্ন ও কলামের শিরোনাম। বের করা প্রতিটি সারির সঙ্গে পৃষ্ঠা নম্বর রাখুন। কলাম সরে গেলে একটি সঠিক সংখ্যাও ভুল দাবিতে পরিণত হতে পারে।
তৃতীয়ত, সহকারীকে শুধু যাচাই করা টেক্সট থেকে উত্তর দিতে বলুন। প্রতিটি গুরুত্বপূর্ণ বক্তব্যের জন্য উৎসের রেফারেন্স চান, আর কোনো ক্ষেত্র অনুপস্থিত থাকলে স্পষ্টভাবে অজানা লিখতে বলুন। প্রতিলিপির প্রশ্ন আর ব্যাখ্যার প্রশ্ন আলাদা রাখুন।
একাধিক পৃষ্ঠাজুড়ে থাকা টেবিল কীভাবে যাচাই করবেন
পুনরাবৃত্ত হেডার হলো লেবেল, অতিরিক্ত ডেটা সারি নয়। সাবটোটালকে তার অন্তর্ভুক্ত এন্ট্রিগুলির সঙ্গে আবার যোগ করা যাবে না। কোনো সারি পরের পৃষ্ঠায় গড়ালে একত্র করার আগে তার শনাক্তকারী মিলিয়ে নিন; দেখতে একই রকম দুটি বিবরণ ভিন্ন ভিন্ন রেকর্ডের হতে পারে।
স্প্রেডশিটে এক্সপোর্ট করার আগে মূল সারিগুলি গুনুন, প্রতিটি সংখ্যার কলামের একক নিশ্চিত করুন এবং অন্তত একটি মোট হাতে মিলিয়ে দেখুন। স্ক্যানে সম্ভবত কী ছিল তা সহকারীকে অনুমান করতে না বলে অনিশ্চিত অক্ষরগুলিকে অনিশ্চিত হিসেবেই রেখে দিন।
জানা উত্তরসহ একটি নথি-বিশ্লেষণের প্রম্পট চালিয়ে দেখুন
এই কাল্পনিক টেক্সট অনুশীলনটি যাচাই করে টেক্সট বের করার পরের যুক্তি, OCR মডেলকে নয়। কোনো ফাইল আপলোড লাগে না। সঠিক ফলাফল: A17 = 40 ইউনিট এবং B22 = 25 ইউনিট, মোট 65 ইউনিট। পুনরাবৃত্ত শিরোনাম কিছুই যোগ করে না, আর কোনো চালানেরই পেমেন্টের অবস্থা জানা নেই।
সহকারী যদি বলে চালানগুলি পরিশোধিত, কোনো সারি দুবার গোনে বা শিরোনামকে একটি আইটেম ধরে, তবে ফলাফল ব্যর্থ। অন্য নথিতে ব্যবহারের আগে প্রতিটি সারির পৃষ্ঠা উল্লেখ করতে বলুন।
শুধুমাত্র এই কাল্পনিক, আগে থেকে বের করা নথিটি ব্যবহার করুন। পৃষ্ঠা 1: শিরোনাম চালান | পরিমাণ; সারি A17 | 40 ইউনিট। পৃষ্ঠা 2: পুনরাবৃত্ত শিরোনাম চালান | পরিমাণ; সারি B22 | 25 ইউনিট। পেমেন্টের অবস্থা কোথাও উল্লেখ নেই। চালান আইডি, পরিমাণ, উৎস পৃষ্ঠা ও পেমেন্টের অবস্থাসহ একটি টেবিল দিন। দুটি পরিমাণ একবারই যোগ করুন। অনুপস্থিত পেমেন্টের অবস্থা অজানা হিসেবে চিহ্নিত করুন। ব্যাখ্যা করুন কেন পুনরাবৃত্ত শিরোনাম ডেটা সারি নয়। পেমেন্ট অনুমান করবেন না এবং অনুপস্থিত ক্ষেত্র বানিয়ে বলবেন না। বাংলায় উত্তর দিন।আপনার নথির জন্য OCR টুল বাছাই
পুরো আর্কাইভ প্রক্রিয়া করার আগে কয়েক ধরনের প্রতিনিধিত্বমূলক নমুনা পরীক্ষা করুন: একটি পরিষ্কার পৃষ্ঠা, একটি নিম্নমানের স্ক্যান, একটি বহু-কলামের পৃষ্ঠা এবং একাধিক পৃষ্ঠায় ভাগ হওয়া একটি টেবিল। নিজের ফাইলে ব্যবহৃত ভাষা ও লিপি যাচাই করুন। একটি ভাষায় বা পরিষ্কার নমুনায় সফল হওয়া মানে প্রতিটি নথিতে নির্ভুলতা নিশ্চিত নয়।
গোপনীয় নথির ক্ষেত্রে আপলোডের আগে দেখে নিন প্রক্রিয়াকরণ কোথায় হয় এবং পরিষেবার ডেটা-ব্যবস্থাপনার শর্ত কী। কর্মপ্রবাহ মূল্যায়নের সময় কাল্পনিক বা সংবেদনশীল অংশ ঢেকে দেওয়া নমুনা ব্যবহার করুন। উন্মুক্ত মডেল ওয়েট আর হোস্ট করা পরিষেবা দুটি ভিন্ন ডিপ্লয়মেন্ট বিকল্প, যাদের পরিচালনার চাহিদাও আলাদা।
কার্যকর ফলাফল হলো এমন ডেটা, যার উৎস খুঁজে নিয়ে আপনি যাচাই করতে পারেন। টেক্সট বের করার গতির পাশাপাশি সংশোধনের সময় ও বাদ পড়া সারিও মাপুন; পরে কাউকে যদি টেবিলটি আবার বানাতে হয়, তবে দ্রুত আউটপুটের কোনো মূল্য নেই।
প্রশ্ন ও উত্তর
OCR কি নিজে থেকেই নির্ভরযোগ্য সারাংশ দেয়?
না। OCR টেক্সট বের করে; সারাংশ সেই টেক্সটের ব্যাখ্যা করে। প্রথমে উৎসের গুরুত্বপূর্ণ বিবরণ যাচাই করুন, যাতে টেক্সট বের করার ভুল আত্মবিশ্বাসী সিদ্ধান্তে পরিণত না হয়।
Unlimited মানে কি সীমাহীন বিনামূল্যের প্রসেসিং?
এখানে এমন কোনো পরিষেবার নিশ্চয়তা প্রতিষ্ঠিত হয়নি। হোস্ট করা পরিষেবার শর্ত বা মডেলটি নিজে চালাতে প্রয়োজনীয় রিসোর্স যাচাই করুন।
GO AI-এর উদাহরণ কি স্ক্যান করা PDF শনাক্তকরণ পরীক্ষা করে?
না। এটি একটি আলাদা ধাপ যাচাই করে: ইতিমধ্যে বের করা কাল্পনিক টেক্সট নিয়ে যুক্তি করা। উত্তরমালা আমাদের লেখা, কোনো OCR মডেলের রেকর্ড করা ফলাফল নয়।
উৎস ও সম্পাদকীয় নোট
প্রকাশিত তথ্যের সঙ্গে উৎসের লিংক আছে। GO AI বিশ্লেষণ চিহ্নিত অংশে আমাদের ব্যাখ্যা; প্রম্পটগুলো পরামর্শ, নথিভুক্ত পরীক্ষার ফল নয়।
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27