Notícias de IA
Unlimited OCR 2: PDF escaneado para texto e extração de tabelas
Conheça o Unlimited OCR 2 da Baidu para converter PDF escaneado em texto e extrair tabelas. Confira os dados antes de pedir um resumo à IA.
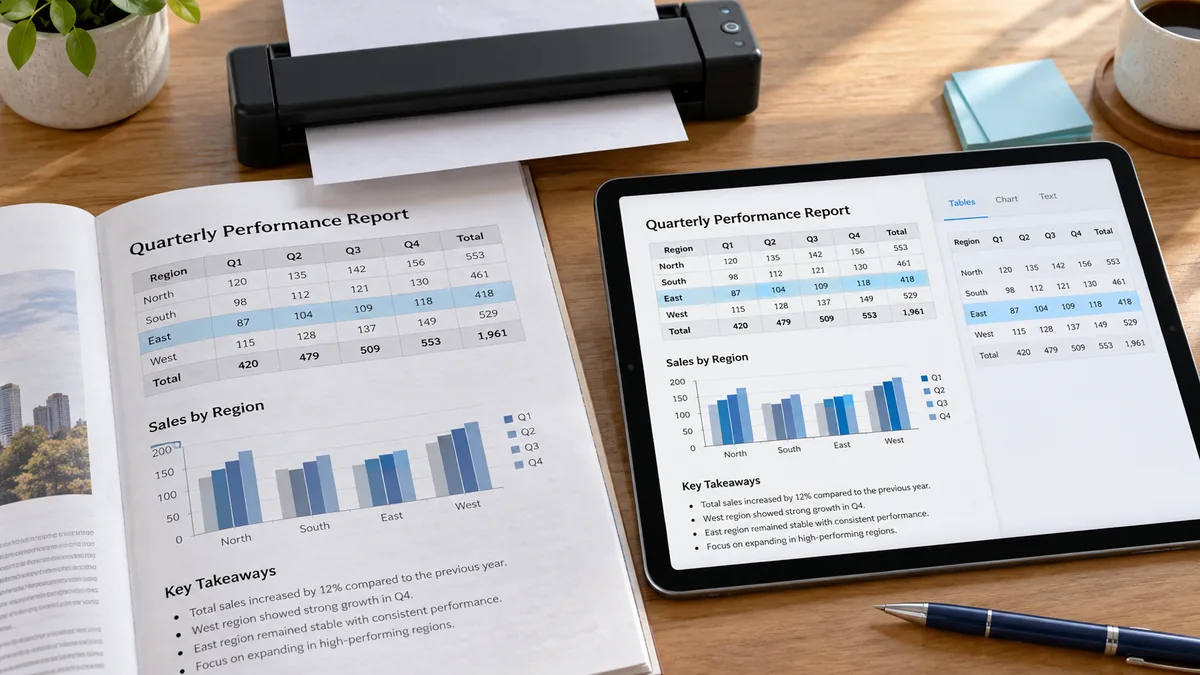
Um PDF digitalizado pode parecer perfeitamente legível para você e ainda assim ser difícil de pesquisar, copiar ou resumir. O OCR transforma a imagem da página em texto; a análise de documentos adiciona estrutura, como títulos e tabelas.
O Unlimited OCR 2 é um novo lançamento nesse fluxo de trabalho. Este guia explica o anúncio e oferece um pequeno exercício verificável para a próxima etapa: transformar o texto extraído em uma resposta precisa.
Visão rápida
- Lançamento
- A Baidu anunciou o Unlimited OCR 2 em 27 de outubro de 2026.
- Foco
- Análise de documentos longos, estrutura de layout e conteúdo que continua de uma página para outra.
- Acesso
- O anúncio traz links para os pesos do modelo e para serviços hospedados de teste público.
O que o Unlimited OCR 2 acrescenta?
A Baidu descreve o reconhecimento estruturado de títulos, parágrafos, tabelas e outros elementos de layout, incluindo a união de tabelas e texto divididos entre páginas. O lançamento é voltado a documentos muito longos. O nome Unlimited não garante uso hospedado ilimitado: confira os limites do serviço e os requisitos de implantação da opção escolhida.
PDF digitalizado para texto: use um fluxo de trabalho de três etapas
Primeiro, identifique a entrada. Se o texto não puder ser selecionado, pode ser necessária uma etapa de OCR. Se puder ser selecionado, mas uma tabela for copiada para as colunas erradas, concentre-se na extração do layout. Mantenha as páginas originais ao lado da versão extraída para que a estrutura possa ser verificada.
Segundo, inspecione os detalhes de alto valor: identificadores, datas, separadores decimais, sinais negativos e títulos de coluna. Mantenha o número da página em cada linha extraída. Um deslocamento de coluna pode transformar um número exato em uma afirmação incorreta.
Terceiro, peça ao assistente que responda apenas com base no texto verificado. Exija uma referência de origem para cada afirmação importante e um "desconhecido" explícito quando um campo estiver faltando. Separe uma pergunta de transcrição de uma pergunta de interpretação.
Como verificar tabelas que abrangem várias páginas
Cabeçalhos repetidos são rótulos, não linhas de dados extras. Um subtotal não deve ser adicionado novamente às entradas subjacentes. Quando uma linha continua em outra página, verifique seu identificador antes de mesclá-la; duas descrições semelhantes podem pertencer a registros diferentes.
Antes de exportar para uma planilha, conte as linhas originais, confirme a unidade de cada coluna numérica e compare pelo menos um total manualmente. Preserve os caracteres incertos como incertos, em vez de pedir ao assistente que adivinhe o que a digitalização provavelmente dizia.
Experimente um prompt de análise de documento com uma resposta conhecida
Este exercício de texto fictício testa o raciocínio após a extração, não o modelo de OCR em si. Não requer upload de arquivo. O resultado correto tem A17 = 40 unidades e B22 = 25 unidades, totalizando 65 unidades. O título repetido não acrescenta nada, e nenhum dos dois status de pagamento é conhecido.
Se o assistente disser que as faturas foram pagas, duplicar uma linha ou tratar o título como um item, o resultado é reprovado. Peça que ele cite a página de cada linha antes de usá-la em outro documento.
Use apenas este documento fictício extraído. Página 1: título Fatura | Valor; linha A17 | 40 unidades. Página 2: título repetido Fatura | Valor; linha B22 | 25 unidades. Nenhum status de pagamento é indicado. Retorne uma tabela com ID da fatura, valor, página de origem e status de pagamento. Some os dois valores uma única vez. Marque o status de pagamento ausente como desconhecido. Explique por que títulos repetidos não são linhas de dados. Não infira pagamentos nem invente campos ausentes.Como escolher uma ferramenta de OCR para seus documentos
Antes de processar um acervo, teste amostras variadas: uma página nítida, uma digitalização ruim, uma página com várias colunas e uma tabela dividida entre páginas. Confira o idioma e o sistema de escrita dos arquivos. Acertar um exemplo ou idioma não garante precisão em todos os documentos.
Antes de enviar material confidencial, confira onde ocorre o processamento e as condições de tratamento de dados. Faça a avaliação com exemplos fictícios ou com informações sensíveis ocultadas. Rodar um modelo de pesos abertos e usar um serviço hospedado são opções diferentes, com requisitos operacionais distintos.
Um resultado útil são dados rastreáveis que você pode verificar. Meça o tempo de correção e as linhas faltantes, além da velocidade de extração; uma saída mais rápida não tem valor se alguém precisar reconstruir a tabela depois.
Perguntas e respostas
O OCR produz automaticamente um resumo confiável?
Não. O OCR extrai o texto; o resumo o interpreta. Verifique primeiro os detalhes importantes da fonte para que erros de extração não se tornem conclusões confiantes.
Unlimited significa processamento gratuito ilimitado?
Nenhuma garantia de serviço desse tipo é estabelecida aqui. Verifique os termos do serviço hospedado ou os recursos necessários para executar o modelo.
O exemplo do GO AI testa o reconhecimento de PDF digitalizado?
Não. Ele testa uma etapa separada: o raciocínio sobre um texto fictício já extraído. O gabarito foi escrito por nós; não é um resultado registrado do modelo de OCR.
Fontes e nota editorial
Os fatos do anúncio têm links para suas fontes. As seções Análise da GO AI trazem nossa interpretação; os prompts são sugestões, não resultados de testes registrados.
- Baidu: Unlimited OCR 2 release and public test — 2026-10-27